Introduction
C’est une situation que tout pentester connaît bien. Le rapport doit être livré demain, et il reste encore des sorties d’outils à analyser et une vulnérabilité à exploiter. Un assistant IA ferait gagner des heures au pentester, mais chaque ligne de ses notes contient des informations sensibles : adresses IP, noms de serveurs, failles pas encore corrigées. Les coller dans un chatbot en ligne ? Ce serait mettre en péril la confidentialité des données du client.
Les modèles d’intelligence artificielle offrent de nouvelles capacités d’analyse et d’assistance aux pentesters, mais la plupart sont proposés sous forme de services SaaS et traitent les données sur des serveurs externes.
Chez MA Cyber, nous voulions tirer parti de l’IA pour livrer des audits de meilleure qualité, dans des délais plus courts, tout en garantissant la protection des données de nos clients. Une question a alors lancé notre projet :
Et si, au lieu d’envoyer nos données vers l’IA, on faisait venir l’IA chez nous ?
Nous avons donc mené un projet de R&D pour déployer un modèle d’IA entièrement hébergé en interne, capable d’assister les pentesters sans aucun risque de fuite de données. Restait à trouver le bon modèle.
Cas d’usage
L’objectif de ce projet est de réaliser un benchmark de plusieurs modèles LLM open source. Mais avant de partir à la recherche du bon modèle, il fallait savoir précisément ce qu’on attendait de lui.
On aurait pu se baser sur des benchmarks d’IA existants, spécialisés en cybersécurité, comme le fameux CyberGym. Toutefois, les benchmarks cyber sont globaux à l’ensemble de la cybersécurité et pas forcément spécialisés en test d’intrusion. Par exemple, l’efficacité d’un modèle à corriger une vulnérabilité nous importe peu en pentest. Également, ces derniers sont souvent basés sur des scénarios utilisant des vulnérabilités publiées (CVE), donc sur lesquels les modèles ont déjà pu s’entrainer. Ce n’est pas non plus un cas d’usage classique en pentest. Par conséquent, nous avons décidé de définir nous-mêmes notre benchmark.
Nous sommes donc partis du terrain pour définir sept cas d’usage où l’IA pourrait aider nos pentesters au quotidien :
- CU 1 – Aide à la recherche de vulnérabilités : l’IA doit permettre à l’auditeur d’identifier rapidement les vulnérabilités et CVE connues d’un produit ciblé, afin d’accélérer la phase de reconnaissance lors d’un audit.
- CU 2 – Aide à l’exploitation : une fois une vulnérabilité détectée, l’IA doit aider l’auditeur à générer des payloads adaptés au contexte et aux protections en place, pour simplifier les tests d’exploitation.
- CU 3 – Aide à la veille : l’IA doit aider l’auditeur à automatiser et optimiser sa veille technique pour rester informé des dernières vulnérabilités, techniques d’attaque et outils, et gagner ainsi en efficacité et en pertinence.
- CU 4 – Aide à la rédaction : l’IA doit aider les auditeurs à produire des rapports clairs et adaptés au niveau de leur audience, qu’elle soit technique ou non, tout en réduisant le temps consacré à la rédaction.
- CU 5 – Aide à la reformulation : l’IA doit aider les auditeurs à améliorer la clarté, la structure et le style de leurs textes, en reformulant ou en corrigeant la syntaxe selon le ton souhaité.
- CU 6 – Aide à l’analyse de fichiers : l’auditeur doit pouvoir téléverser des fichiers, par exemple issus d’outils d’audit ou de la documentation, pour que l’IA en extraie automatiquement les informations et lui fasse gagner du temps.
- CU 7 – Mise à disposition de ressources web : l’auditeur doit pouvoir fournir des liens vers des sources spécifiques ou laisser l’IA rechercher automatiquement sur le web, afin d’obtenir des réponses toujours actuelles et pertinentes.
Prérequis
Pour faire tourner les modèles, nous avons utilisé une machine déjà en notre possession, celle qui nous sert habituellement à casser des mots de passe, la “crackstation”. Pourquoi cette machine ? Car l’IA et le cassage de mot de passe ont une gourmandise commune, les GPU !
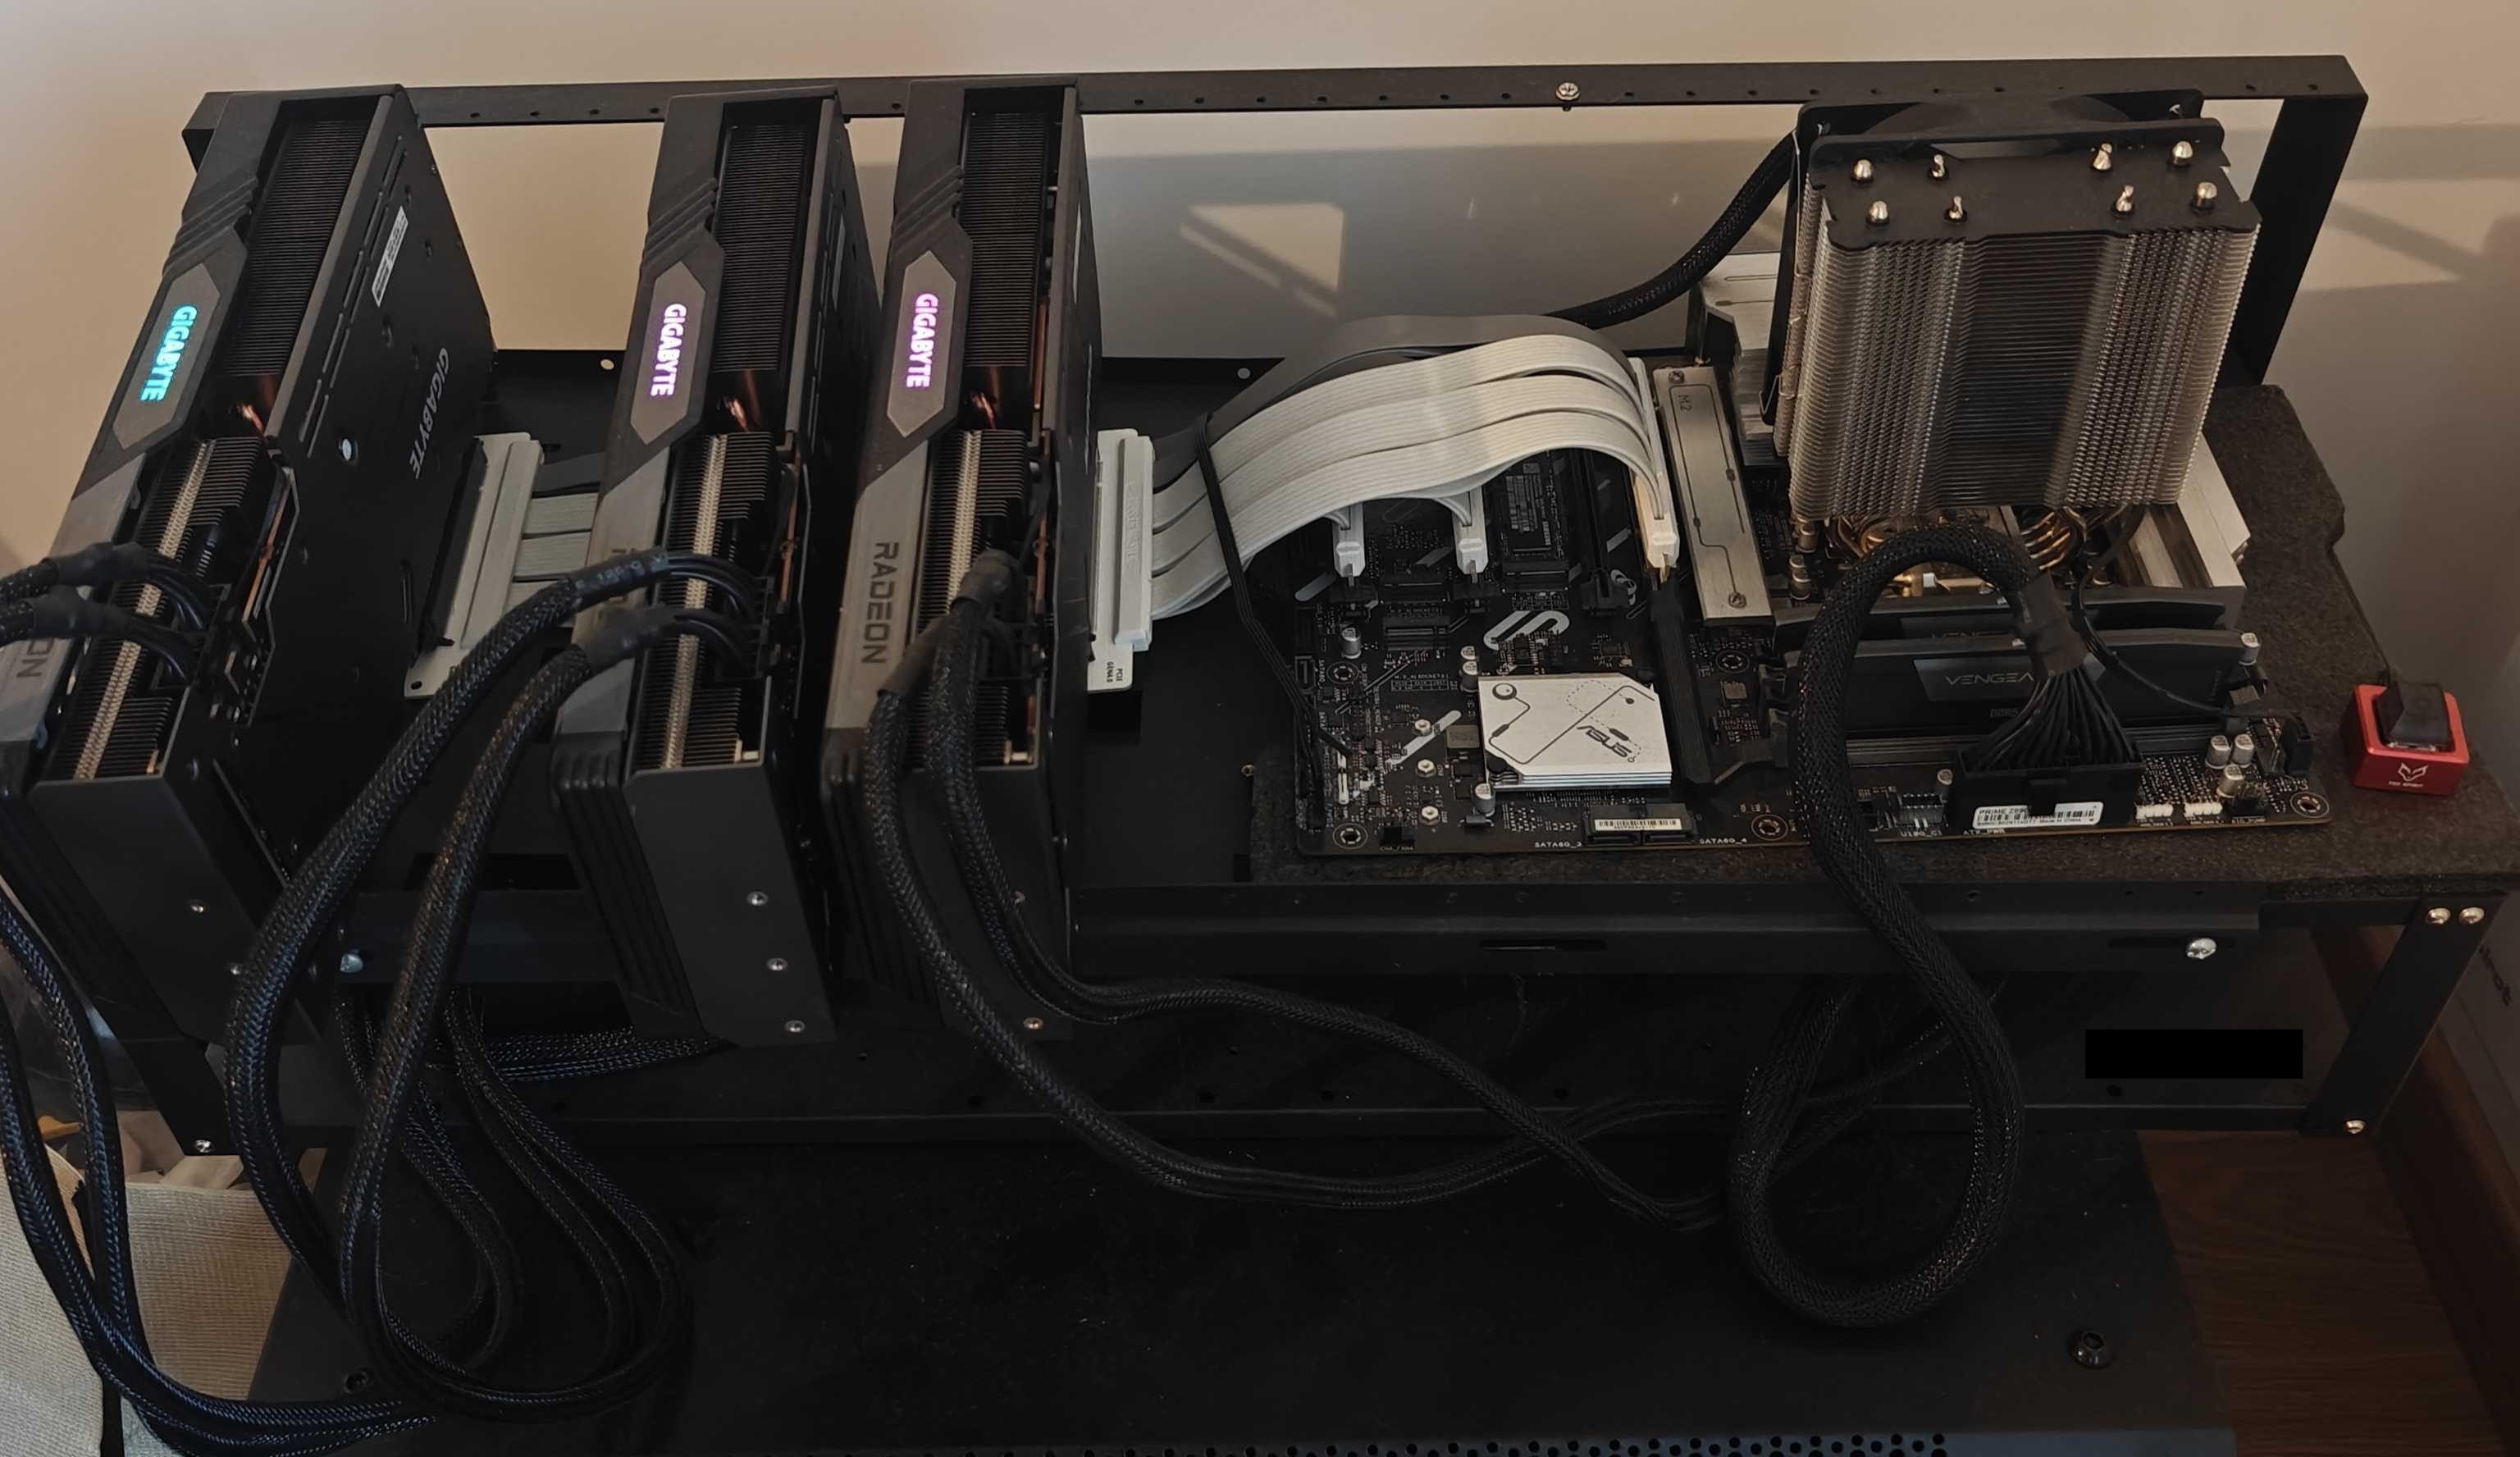
Hardware de la crackstation :
- Système d’exploitation : Windows 11
- Processeur : Intel(R) Core(TM) Ultra 7 265K 3.90 GHz
- Mémoire vive : 64 Go de RAM
- Cartes graphiques : 3 × AMD Radeon RX 7800 XT 16 Go
- Stockage : 1 To
Une machine solide, mais nous étions contraints par le hardware. Avec 48 Go de VRAM, seuls les modèles d’une trentaine de milliards de paramètres tournaient de façon fluide. Au-delà, ils devaient s’appuyer en partie sur les 64 Go de RAM, au prix de temps de réponse bien plus longs. Et pour les plus gros modèles, c’était tout simplement hors de portée.
Autre prérequis important : La confidentialité des données de nos clients est primordiale pour nous. Nous avons donc décidé de ne pas laisser d’accès à Internet à la crackstation hébergeant les modèles. Au-delà du fait que cela augmente la surface d’attaque sur la machine, nous voulions aussi rendre complètement impossible toute fuite de données par les modèles eux-mêmes (recherche Google avec des données sensibles, envoi de metrics non-voulu, fuite de données accidentelle, ingérence potentielle, etc.).
Tous les modèles ont été exécutés sur Ollama, simple à configurer et parfaitement adapté à notre usage. Nous avons également utilisé Open WebUI, une interface web conviviale qui facilite les échanges avec les modèles.
Expérimentation
Deux profils de modèles nous intéressaient : des modèles généralistes, capables de gérer une large variété de tâches, et des modèles spécialisés, entraînés sur des datasets liés à la cybersécurité.
Modèles généralistes
Nous avons commencé par explorer les modèles généralistes. L’idée était de trouver des modèles à la fois puissants, capables de tourner sur notre machine, et fiables pour générer des réponses satisfaisantes. On s’est donc concentrés sur les principales familles proposées par les fournisseurs, en comparant leurs versions, leur taille et leurs performances rapportées dans les leaderboards publics, pour repérer ceux qui tenaient vraiment la route.
Premier obstacle : comme nous n’avons pas trouvé de classement spécifique au domaine d’application de la cybersécurité, nous nous sommes appuyés sur des leaderboards généralistes comme LiveBench et LM Arena comme point de départ pour orienter notre sélection.
À l’issue de cette phase, nous avons présélectionné 12 familles pour l’expérimentation : GPT-oss, Deepseek, Llama, Qwen, Phi, Gemma, Mistral, GLM, Cogito, Calme, Command A et Nemotron.
Modèles spécialisés
Nous nous sommes ensuite intéressés aux modèles spécialisés en cybersécurité. Beaucoup de travaux utilisent des modèles généralistes combinés à des agents IA, mais notre objectif était de travailler avec des modèles entraînés directement sur des datasets de cybersécurité.
Pour les trouver, nous avons lancé une recherche sur Hugging Face avec des mots-clés comme Cybersec et pentest, et nous avons identifié environ 150 modèles. Mais seuls 26 d’entre eux disposaient d’une documentation.
Nous avons alors appliqué des critères plus stricts : qualité et complétude de la documentation, popularité (téléchargements et likes), ancienneté ou mise à jour récente, et notoriété de l’auteur ou de l’organisation à l’origine du modèle. Au final, 11 modèles spécialisés ont été retenus pour l’expérimentation.
Présélection des modèles
Avant même de comparer les réponses des modèles, nous avons commencé par examiner leurs contraintes techniques. Chaque LLM a une longueur de contexte maximale, c’est-à-dire le nombre total de tokens qu’il peut traiter en une seule fois. Cela inclut l’ensemble des messages d’une discussion, les instructions système ainsi que d’éventuels fichiers ou contenus injectés dans le prompt. Comme nos cas d’usage (présentés plus haut) impliquaient des échanges longs et du contenu technique dense, nous avons retenu uniquement les modèles capables de gérer au moins 32 000 tokens.
Cette longueur de contexte a toutefois un impact direct sur le TPOT (Time Per Output Token), le temps moyen nécessaire pour générer chaque mot (token) de la réponse. Plus le contexte est large, plus ce temps augmente. Or, pour un assistant utilisé au quotidien, des temps de réponse raisonnables sont indispensables. Nous avons donc mesuré le TPOT pour chaque modèle et écarté tous ceux qui dépassaient 150 ms par token.
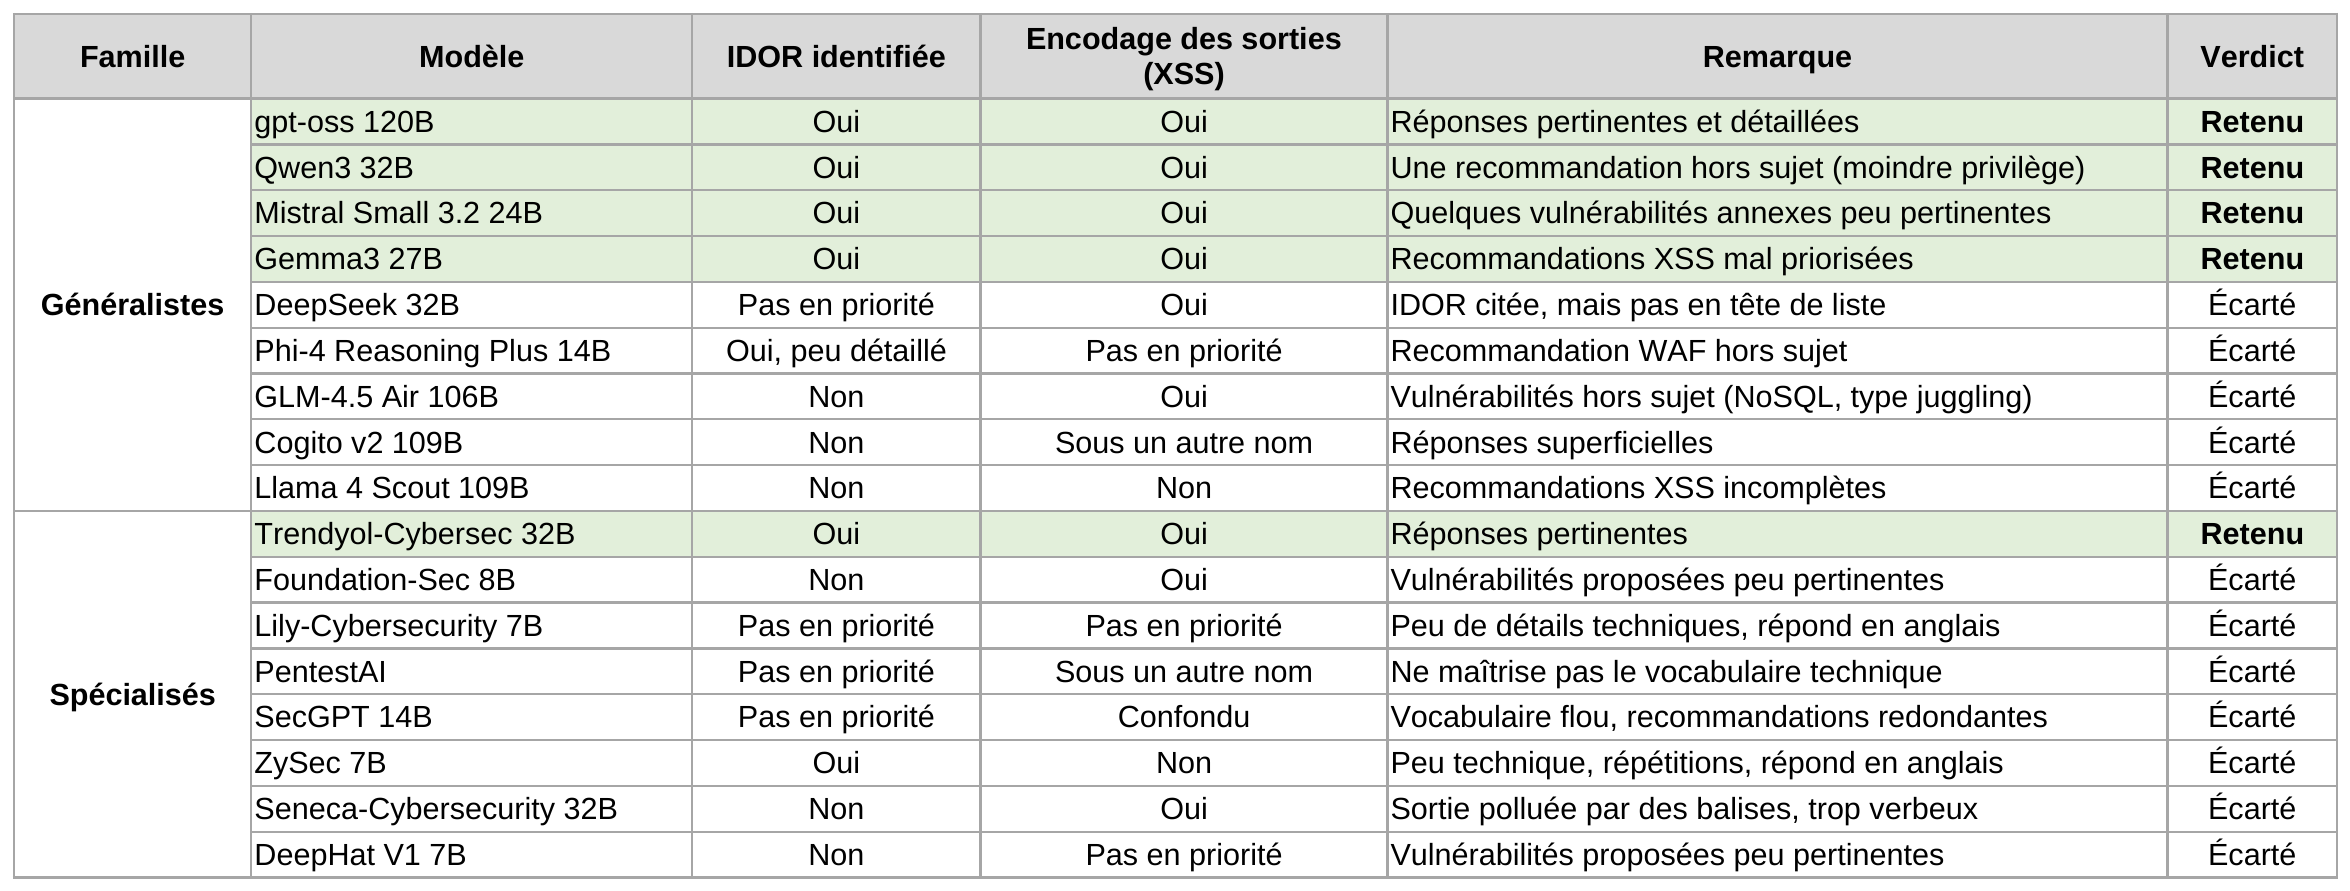
À l’issue de ce premier tri, 17 modèles ont été retenus, dont 9 généralistes et 8 spécialisés. Ce nombre restait trop important pour tous les tester de façon adéquate. Par conséquent, nous avons réalisé un second filtre : Nous les avons ensuite soumis à deux scénarios techniques extrêmement simples, à la portée de n’importe quel débutant en cybersécurité :
Le premier prompt décrivait le contexte d’une IDOR et demandait aux modèles d’identifier le type de la vulnérabilité. Le second les invitait à proposer des recommandations pour corriger une XSS.
Chaque modèle a été évalué sur la pertinence de ses réponses, le niveau de détails techniques et la cohérence de ses résultats. À l’issue de cette phase, seulement 5 modèles ont été conservés pour le benchmark final, dont un seul spécialisé. Ce résultat montre que la plupart des modèles spécialisés disponibles sur HuggingFace restent des preuves de concept, pas encore prêts à être déployés en production.
Voici comment les 17 modèles s’en sont sortis sur nos deux scénarios :
Pour ces modèles, nous avons utilisé des versions abliterated, c’est-à-dire des modèles qui ne refusent pas de répondre à certaines requêtes et peuvent générer librement des payloads exploitables. Indispensable quand on fait de l’offensif. Nos cinq finalistes sont :
- gpt-oss:120b
- qwen3:32b
- mistral-small3.2:24b
- gemma3:27b
- Trendyol-Cybersec:32B (spécialisé)
Indicateurs Clés de Performance (KPI)
Pour départager ces cinq finalistes, nous avons défini des KPI (indicateurs clés de performance) précis pour chaque cas d’usage. Ce sont des cas d’usage qu’on retrouve régulièrement au quotidien et qui font partie du métier de pentester :
- CU 1 – Aide à la recherche de vulnérabilités :
- Rapport des CVE correctement identifiées par le modèle, par rapport au nombre total de CVE existantes et au nombre total de CVE retournées, sur 4 versions différentes de phpMyAdmin.
- CU 2 – Aide à l’exploitation : Trois scénarios issus de DVWA (Damn Vulnerable Web Application) et XVWA (eXtreme Vulnerable Web Application). Pour chacun :
- Identification correcte du type de vulnérabilité à partir d’une description fournie.
- Note sur 10 basée sur la pertinence et la qualité des payloads proposés (jugement humain).
- Réussite ou échec de l’exploitation à partir des payloads générés.
- CU 3 – Aide à la veille : Évaluation sur quatre sujets techniques :
- Proportion d’informations exactes fournies par le modèle par rapport à une checklist préparée à l’avance (jugement humain),
- Taux d’hallucinations (jugement humain).
- CU 4 – Aide à la rédaction : Chaque modèle rédige huit sections d’un rapport de pentest à partir d’une description. Un pentesteur confirmé attribue une note sur 10 pour la qualité et la clarté de chaque section (jugement humain).
- CU 5 – Aide à la reformulation : Taux d’erreurs linguistiques corrigées dans un paragraphe tiré d’un rapport d’audit, volontairement rempli de fautes d’orthographe, de grammaire ou de tournure de phrase.
- CU 6 – Aide à l’analyse de fichiers : Taux de réponses correctes et pertinentes sur deux documents techniques téléversés. Ce KPI inclut également le CU 7, car l’extraction d’informations depuis des fichiers fonctionne de la même manière que depuis des pages web.
- Temps de réponse : Classement des modèles selon leur TPOT pour une longueur de contexte donnée.
Résultats clés : le verdict
Nous avons calculé un score pour chaque cas d’usage sous forme de pourcentage, puis un score global, également exprimé en pourcentage, en pondérant chaque CU par un coefficient reflétant son importance dans l’évaluation globale. Deux scores complémentaires ont également été calculés : un score technique, basé sur les CU 1 à 3, et un score rédactionnel, basé sur les CU 4 à 6, tous deux exprimés en pourcentage.
Le tableau suivant synthétise les résultats :
| CU | Coef | gpt-oss | Qwen | Mistral | gemma | Trendyol |
|---|---|---|---|---|---|---|
| CU1 | 5 | 25,00 | 50,00 | 36,20 | 0,00 | 33,77 |
| CU2 | 35 | 47,35 | 61,36 | 79,34 | 74,24 | 77,63 |
| CU3 | 5 | 46,13 | 54,17 | 61,01 | 44,91 | 58,21 |
| CU4 | 20 | 31,88 | 38,75 | 67,50 | 39,38 | 46,25 |
| CU5 | 20 | 58,82 | 70,59 | 82,35 | 94,12 | 64,71 |
| CU6 | 10 | 100,00 | 100,00 | 100,00 | 99,13 | 100,00 |
| Temps | 5 | 22,92 | 58,33 | 66,67 | 100,00 | 50,00 |
| Score Technique | 44,73 | 59,30 | 72,51 | 62,73 | 70,59 | |
| Score Rédaction | 56,28 | 63,74 | 79,94 | 73,22 | 64,38 | |
| Score général | 49,41 | 61,47 | 75,93 | 69,84 | 66,46 |
Pour ceux qui veulent aller plus loin, voici le détail des scores, KPI par KPI :
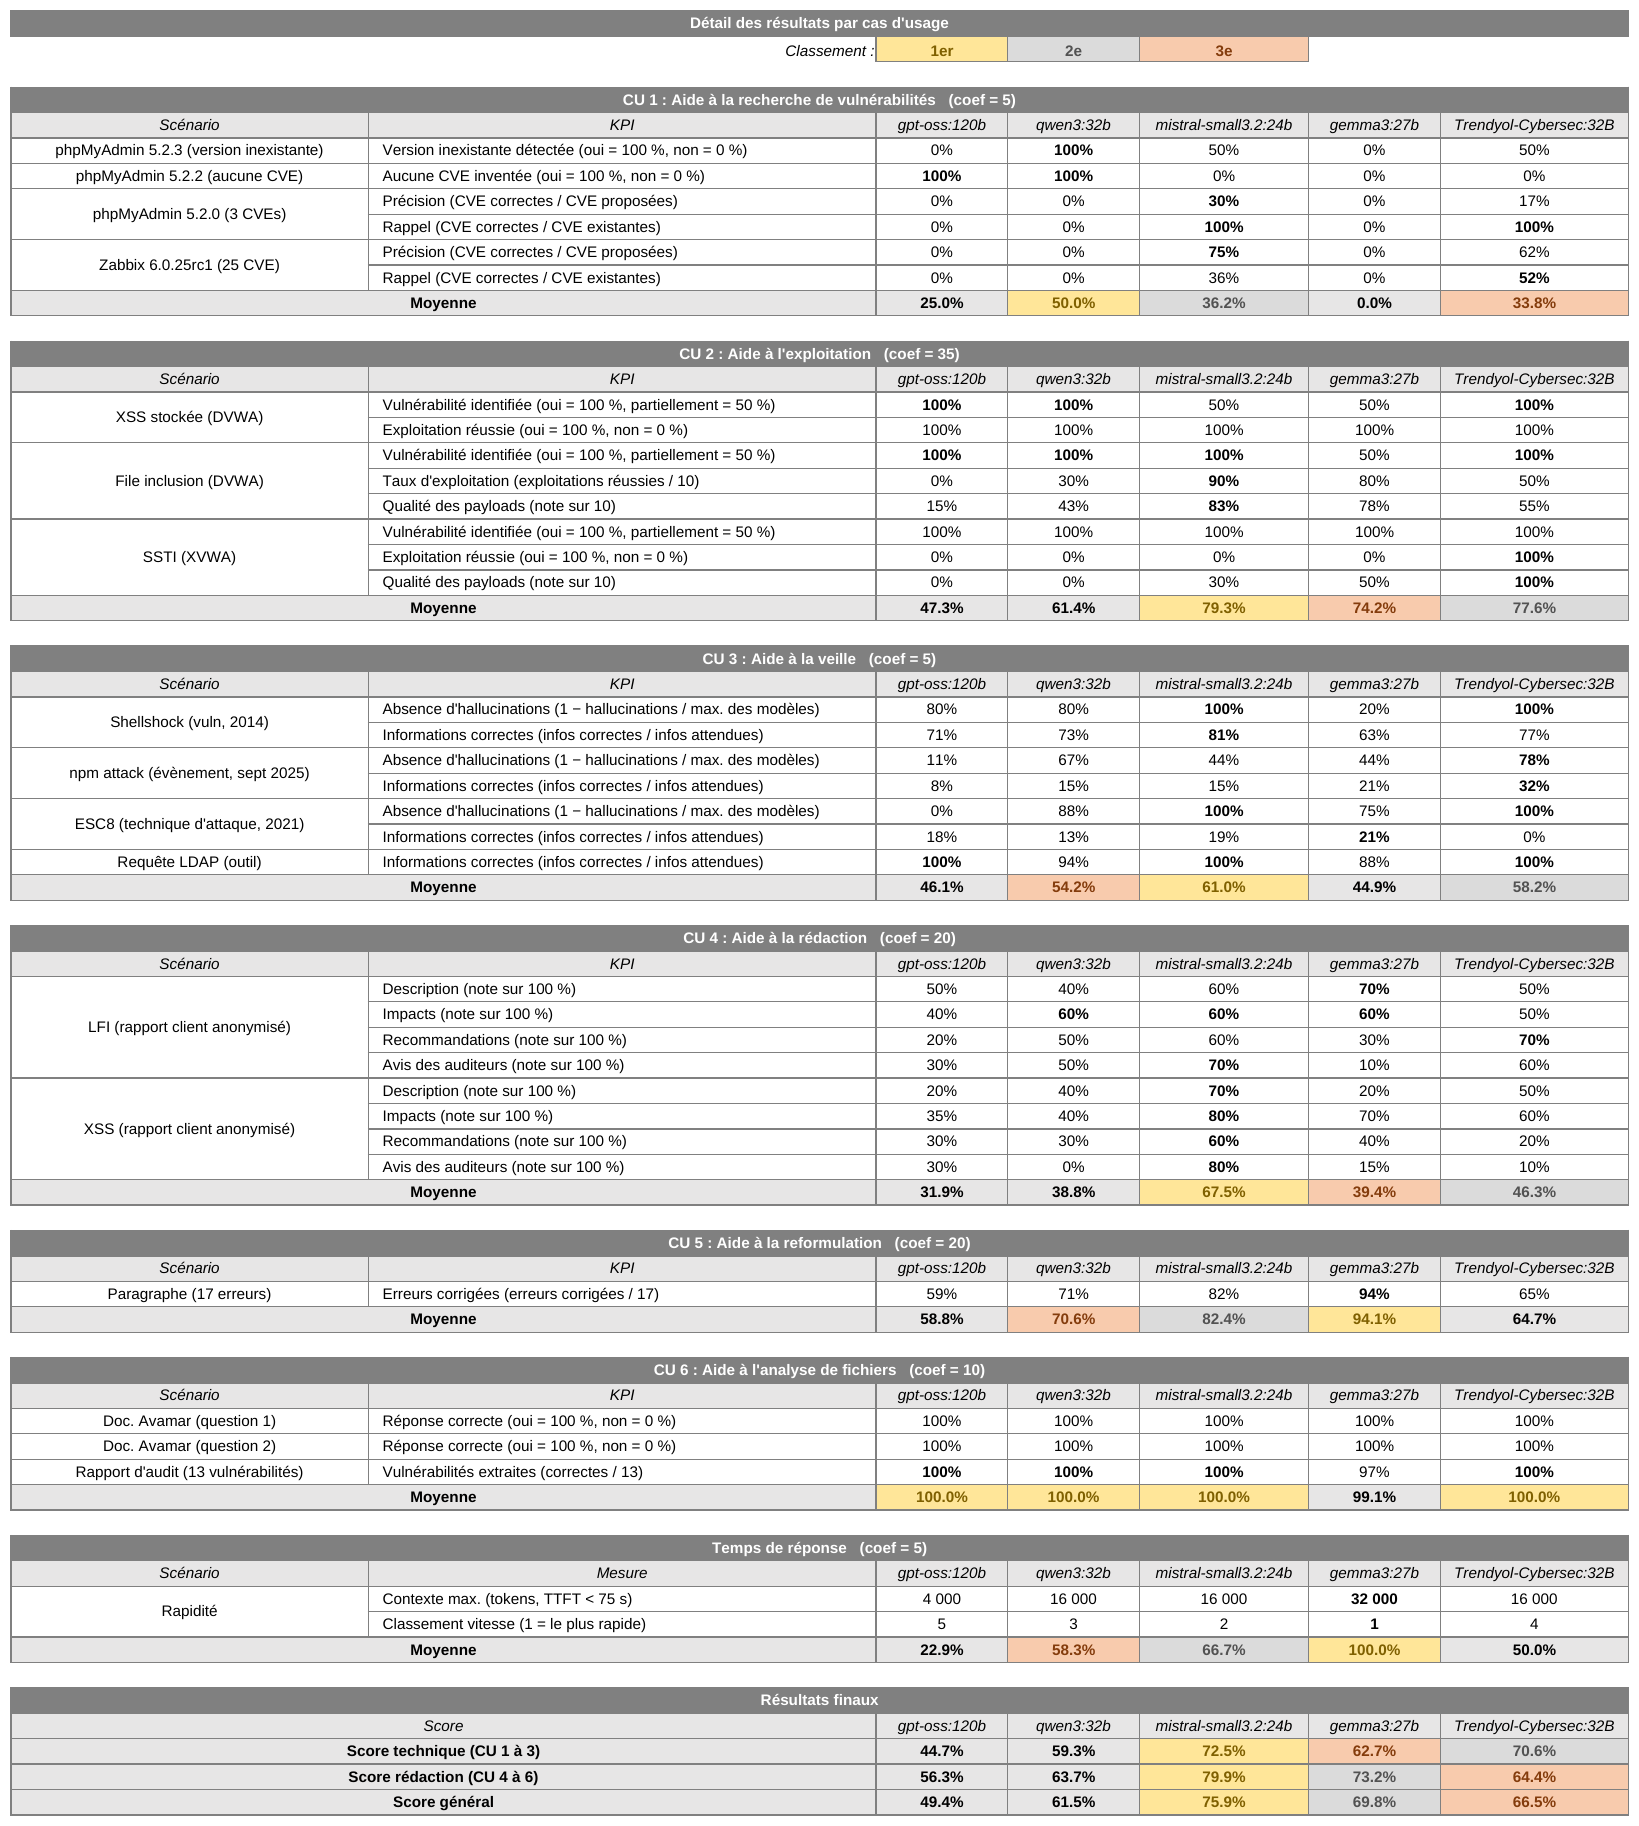
Les résultats permettent de dégager plusieurs tendances. GPT-OSS, pourtant le plus grand des modèles testés, affiche des résultats moyens à faibles, avec des difficultés notables en exploitation de vulnérabilités et en rédaction, ainsi qu’un temps de réponse lent dû à sa taille. Qwen offre des performances moyennes dans l’ensemble. Gemma excelle en reformulation et se montre le plus rapide, mais présente des résultats plus variables dans les autres cas d’usage.
Deux modèles se démarquent. Mistral se distingue comme le modèle le plus performant globalement, particulièrement efficace en rédaction (mais aussi en technique), avec une bonne rapidité de réponse. Trendyol, seul modèle spécialisé parmi les finalistes, montre de bonnes performances techniques, notamment en exploitation de vulnérabilités, avec un équilibre entre rapidité et précision, et le moins d’hallucinations.
Plutôt que de retenir un seul modèle, nous avons fait notre choix selon les usages. Pour les tâches de rédaction, Mistral AI est retenu pour la clarté et la pertinence du contenu produit, ainsi que la constance de ses performances. Pour les besoins techniques, le choix se porte sur un duo Mistral & Trendyol, dont le post-entraînement sur des datasets de cybersécurité a fourni des résultats corrects et fiables sur l’ensemble des scénarios évalués.
Conclusion
Ce benchmark nous a montré qu’on peut laisser les LLM SaaS de côté et se tourner vers des modèles open source hébergés en interne. Nos pentesters n’ont plus à choisir entre gagner du temps et protéger les données de leurs clients : ils peuvent s’appuyer sur Mistral AI pour la rédaction et sur Trendyol-Cybersec pour les tâches techniques.
Ces modèles sont hébergés et exécutés sur notre machine dédiée. En plus des connaissances acquises lors de leur entraînement, ils peuvent analyser des fichiers téléversés et rechercher des informations sur le web en temps réel. Ils offrent ainsi un support concret et efficace au quotidien des auditeurs.
Toutefois, il est à noter que ces résultats ne sont une réalité qu’au moment de la rédaction de cette synthèse. Les évolutions des IA étant tellement rapides, chaque nouveau modèle frontière repousse un peu plus loin les performances sur nos cas d’usage. Les attaquants, eux, utilisent les modèles de frontières. Peut-on réellement les concurrencer sans ?
Besoin d’un accompagnement en cybersécurité ? Chez MA Cyber, nous vous accompagnons dans la sécurisation de vos systèmes. Nos experts tirent parti des avantages de l’IA tout en maîtrisant ses limites et les risques d’exfiltration des données.
FAQ
Qu’est-ce qu’un LLM ?
Un LLM (Large Language Model) est une IA entraînée sur de grandes quantités de textes et de bases de connaissances pour comprendre et générer du langage humain.
Avez-vous développé un agent IA autonome ?
Non. Nous avons fait le choix d'un chatbot destiné à assister nos pentesters pendant leurs missions, plutôt que d'un agent IA qui effectuerait un pentest seul. Ce type d'agent reste aujourd'hui moins efficace qu'un pentesteur expérimenté.
Un LLM peut-il remplacer un pentester ?
Non. Un modèle d’IA ne peut jamais remplacer un test d’intrusion réalisé par un expert. Nos pentesters utilisent l’IA pour accélérer les tâches répétitives et optimiser leur temps. Toutes les réponses générées par les LLM sont minutieusement vérifiées par nos experts.